Локальные модели, проверяемый RAG и агенты, за которыми можно наблюдать.
26 октября – 2 ноября 20268 основных статей3 на радаре
О чём пишут
На этой неделе авторы разбирают, как запускать модели локально и держать агентную работу под контролем. Проверка результата важнее уверенного ответа: код из документации сверяют с исходником, тесты обвязки отделяют от качества модели, а границы моков записывают явно. Есть и практическая сторона автономности: перенос зависимостей без сети и диагностика нескольких сессий. Частные замеры скорости оставлены за рамками обещаний.
Восемь приёмов для своей системы
01
Pi и plan.md берегут контекст локального агента
Евгений ИгумновХабр≈5 минПрограммированиеИскусственный интеллект
О чём
Автор подключает локальную модель из LM Studio к Pi и разделяет планирование и правки на разные сессии. Приём полезен, когда служебные инструкции занимают заметную часть небольшого контекста.
Главное
В ~/.pi/agent/models.json задан OpenAI-совместимый сервер LM Studio на порту 1234 и contextWindow 65536.
План сохраняется в plan.md; команда /new очищает диалог перед реализацией.
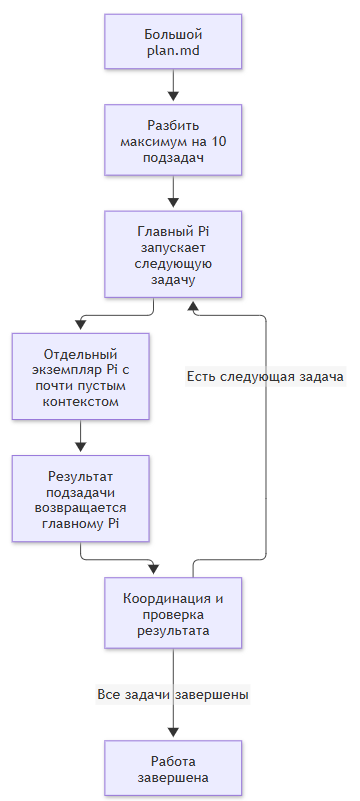
Скилл subtask4llm-pi запускает подзадачи последовательно в отдельных экземплярах агента.
Попробовать за вечер
Добавить провайдер LM Studio в ~/.pi/agent/models.json по образцу статьи и выбрать доступную локальную модель.
В тестовом репозитории попросить Pi составить plan.md, выполнить /new и поручить реализацию по этому файлу.
Метрика: Сравнить число токенов перед правками и долю пройденных тестов с прямым выполнением той же задачи.
Границы рецепта. 125 токенов/с — замер автора на RTX 4070 Ti SUPER, не обещание для другой машины. Часть параметров запуска приведена только на скриншотах; численные сравнения моделей и качества независимо не проверены.
План делится на последовательные подзадачи; каждая выполняется в отдельном Pi с почти пустым контекстом.
Команда Jmix добавила поиск по Javadoc, законченные примеры и проверочный набор вопросов. Здесь полезнее сам способ проверки, чем итоговый счёт: авторы отдельно разобрали ошибки модели, эталонов и автоматического оценщика.
Главное
Код из извлечённых примеров проверяют дословным поиском на исходной странице; такая проверка не доказывает правильность самого кода.
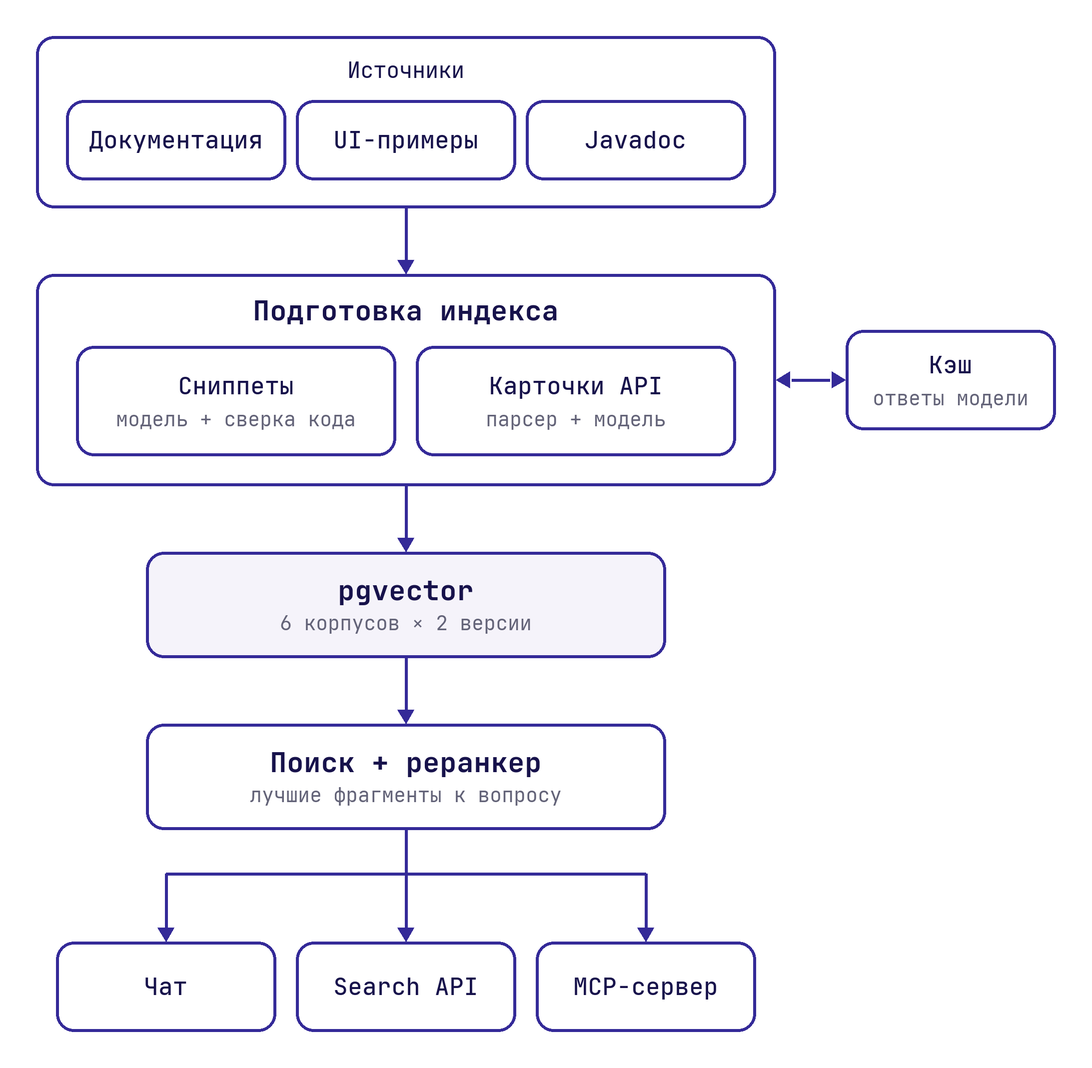
Объявления API извлекают из Javadoc без модели, а описания для поиска добавляют отдельно.
Новая конфигурация получила 71 зачёт из 74 в каждом из двух прогонов; исходная — 68 и 70. Авторы прямо не считают это доказательством преимущества.
Попробовать за вечер
На нескольких страницах своей документации выделить законченные примеры и отклонять блоки кода, которых нет в исходной странице.
Собрать вопросы с эталонами, включая несуществующий метод или параметр; прогнать две конфигурации поиска и вручную разобрать расхождения оценщика.
Метрика: Доля примеров с дословно подтверждённым кодом и число ответов с несуществующим API; повторить прогон, чтобы увидеть разброс.
Границы рецепта. Полного готового стенда в статье нет: свой индексатор и набор вопросов придётся собрать. Корпуса, поиск и промпт менялись одновременно; два прогона без сверки оценщика с людьми не показывают причинный эффект. MCP и Search API количественно не измеряли.
Документация, UI-примеры и Javadoc проходят отдельную подготовку; затем поиск и реранкер передают знания чату, Search API и MCP.
Автор собрал новостной RAG на PostgreSQL, Ollama и LangGraph и опубликовал репозиторий. Из короткого разбора можно перенести конкретные настройки загрузки моделей и разделение агентных инструментов.
Главное
Агент получает отдельные search_articles, get_metrics и search_by_entity, поэтому подсчёты выполняются SQL-инструментом.
OLLAMA_MAX_LOADED_MODELS=2 удерживает две модели загруженными; пригодность настройки зависит от доступной памяти.
Автор перешёл с ChatOllama на ollama.AsyncClient, а в задачах Celery освобождает пул через await engine.dispose().
Попробовать за вечер
Открыть https://github.com/tzar26/news_scrapper, подготовить конфигурацию по README и запустить docker compose up -d.
На своей установке Ollama проверить OLLAMA_MAX_LOADED_MODELS=2 и повторить чередование запросов к чат-модели и эмбеддингам.
Метрика: Время первого и повторного запроса при переключении моделей, расход памяти и корректность вызова get_metrics.
Границы рецепта. Публикация не даёт размера контрольной выборки и условий замера Recall@5; рост 0,2→0,53 нельзя обещать читателю. PostgreSQL tsvector сам по себе не подтверждает реализацию именно BM25. Рецепт запуска зависит от README и железа.
Выбрать квантованную модель на Hugging Face и запустить в Ollama
Алексеев БрониславХабр≈11 минБлог компании BotHubИскусственный интеллект
О чём
Учебная статья проводит от карточки модели до локального запуска или OpenAI-совместимого API. Для первого вечера годится небольшой GGUF: огромные модели из примеров не нужны.
Главное
Перед загрузкой проверяют задачу, лицензию, размер весов и поддержку архитектуры движком.
Для диалога нужна instruct- или chat-версия: base-модель продолжает текст и не обязана следовать инструкции.
Ollama принимает hf.co/автор/репозиторий, а квант можно выбрать тегом; статья даёт команды для Llama 3.2.
Попробовать за вечер
В карточке bartowski/Llama-3.2-1B-Instruct-GGUF проверить лицензию и размер выбранного файла.
При установленной Ollama выполнить ollama run hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF и задать одинаковые вопросы в нескольких сессиях.
Метрика: Модель загружается без ошибки архитектуры, отвечает на инструкции и укладывается в доступную память.
Границы рецепта. Установка Ollama предполагается. В статье перепутано соотношение объёмов float16 и float32; при выборе файла проверяйте размер в репозитории. Рекламные вставки и общие обещания точности квантов не подтверждают качество конкретной модели.
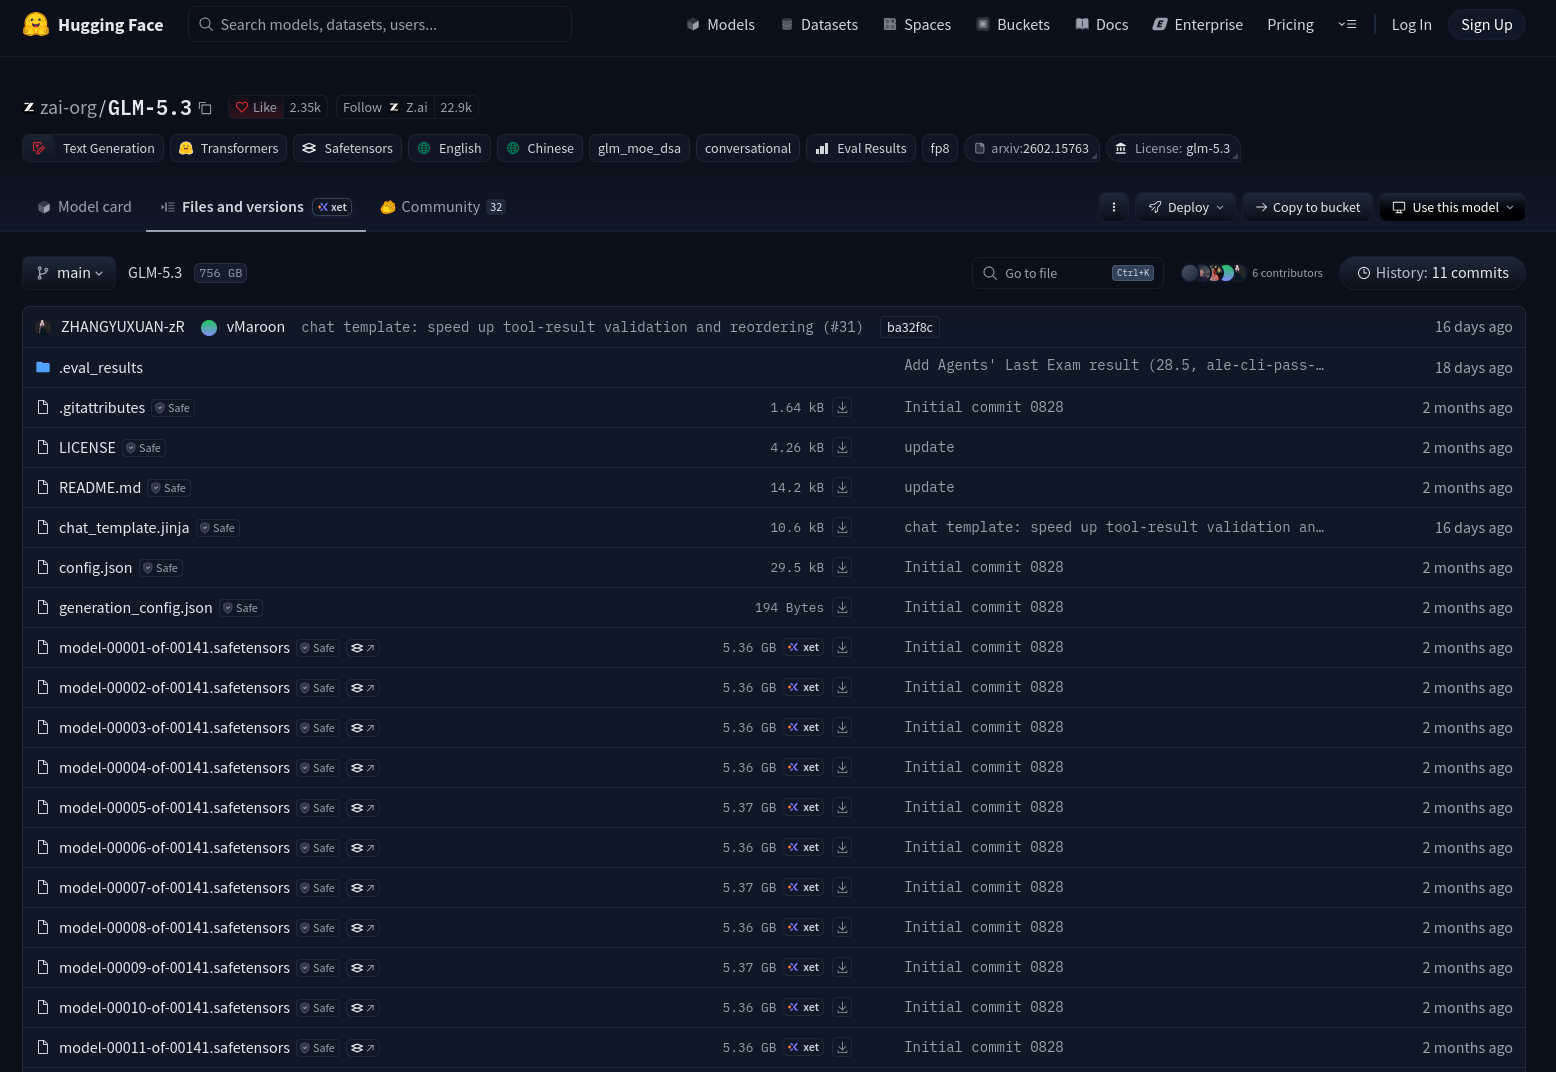
Вкладка Files and versions показывает файлы весов и их размеры. На скриншоте GLM-5.3; для упражнения выше выбрана маленькая Llama.
Как сохранить точные версии Python-зависимостей и развернуть локальный AI-стек на Debian 12 без PyPI. Подходит для переноса уже собранного окружения в изолированную сеть.
CPU-сборку PyTorch скачивают с дополнительного индекса; суффикс +cpu исключает выбор CUDA-сборки.
Модели, бинарники и системные пакеты не входят в репозиторий pip и требуют отдельного переноса.
Попробовать за вечер
В работающем окружении сохраните pip freeze в requirements.lock и скачайте зависимости через pip download с --only-binary=:all: и CPU-индексом PyTorch.
Создайте отдельное тестовое окружение и установите lock-файл с --no-index --find-links=./offline_packages; до удаления окружения выполните pip check.
Метрика: установка завершается без сети, pip check не находит конфликтов, torch сообщает версию с +cpu.
Границы рецепта. Нужны одинаковые ОС, архитектура и версия Python. Системные пакеты apt поставляются отдельно. Код статьи отображён с лишними обратными слешами; пример теста удаляет окружение до следующей проверки pip check, поэтому команды нужно сверить и выполнять в исправленном порядке.
Мод claude-load связывает процессы с сессиями Claude Code и отдельно показывает оставшиеся без родителей инструменты. Подходит для диагностики нагрузки при нескольких параллельных агентах.
Главное
Для атрибуции мод читает ~/.claude/sessions/<pid>.json и проходит дерево PPID.
Один сборщик пишет snapshot.json; сессии читают общий снимок раз в пять секунд.
Перед завершением процесса проверяются свежесть снимка и совпадение имени под PID.
Попробовать за вечер
Для Claude Code 2.1.287+ добавить маркетплейс Gerrux/claude-load и установить claude-load@claude-load по команде статьи.
Выполнить /reload-plugins и /load; сопоставить сессии и процессы со своей работой до завершения любых процессов.
Метрика: у каждой активной сессии видны CPU и RAM; отдельно проверить корректность отнесения знакомого дочернего процесса.
Границы рецепта. Автор не запускал мод на настоящих macOS/Linux: «На настоящем Mac или Linux мод пока не запускался». Скриншоты построены на демо-данных, реестр сессий не документирован.
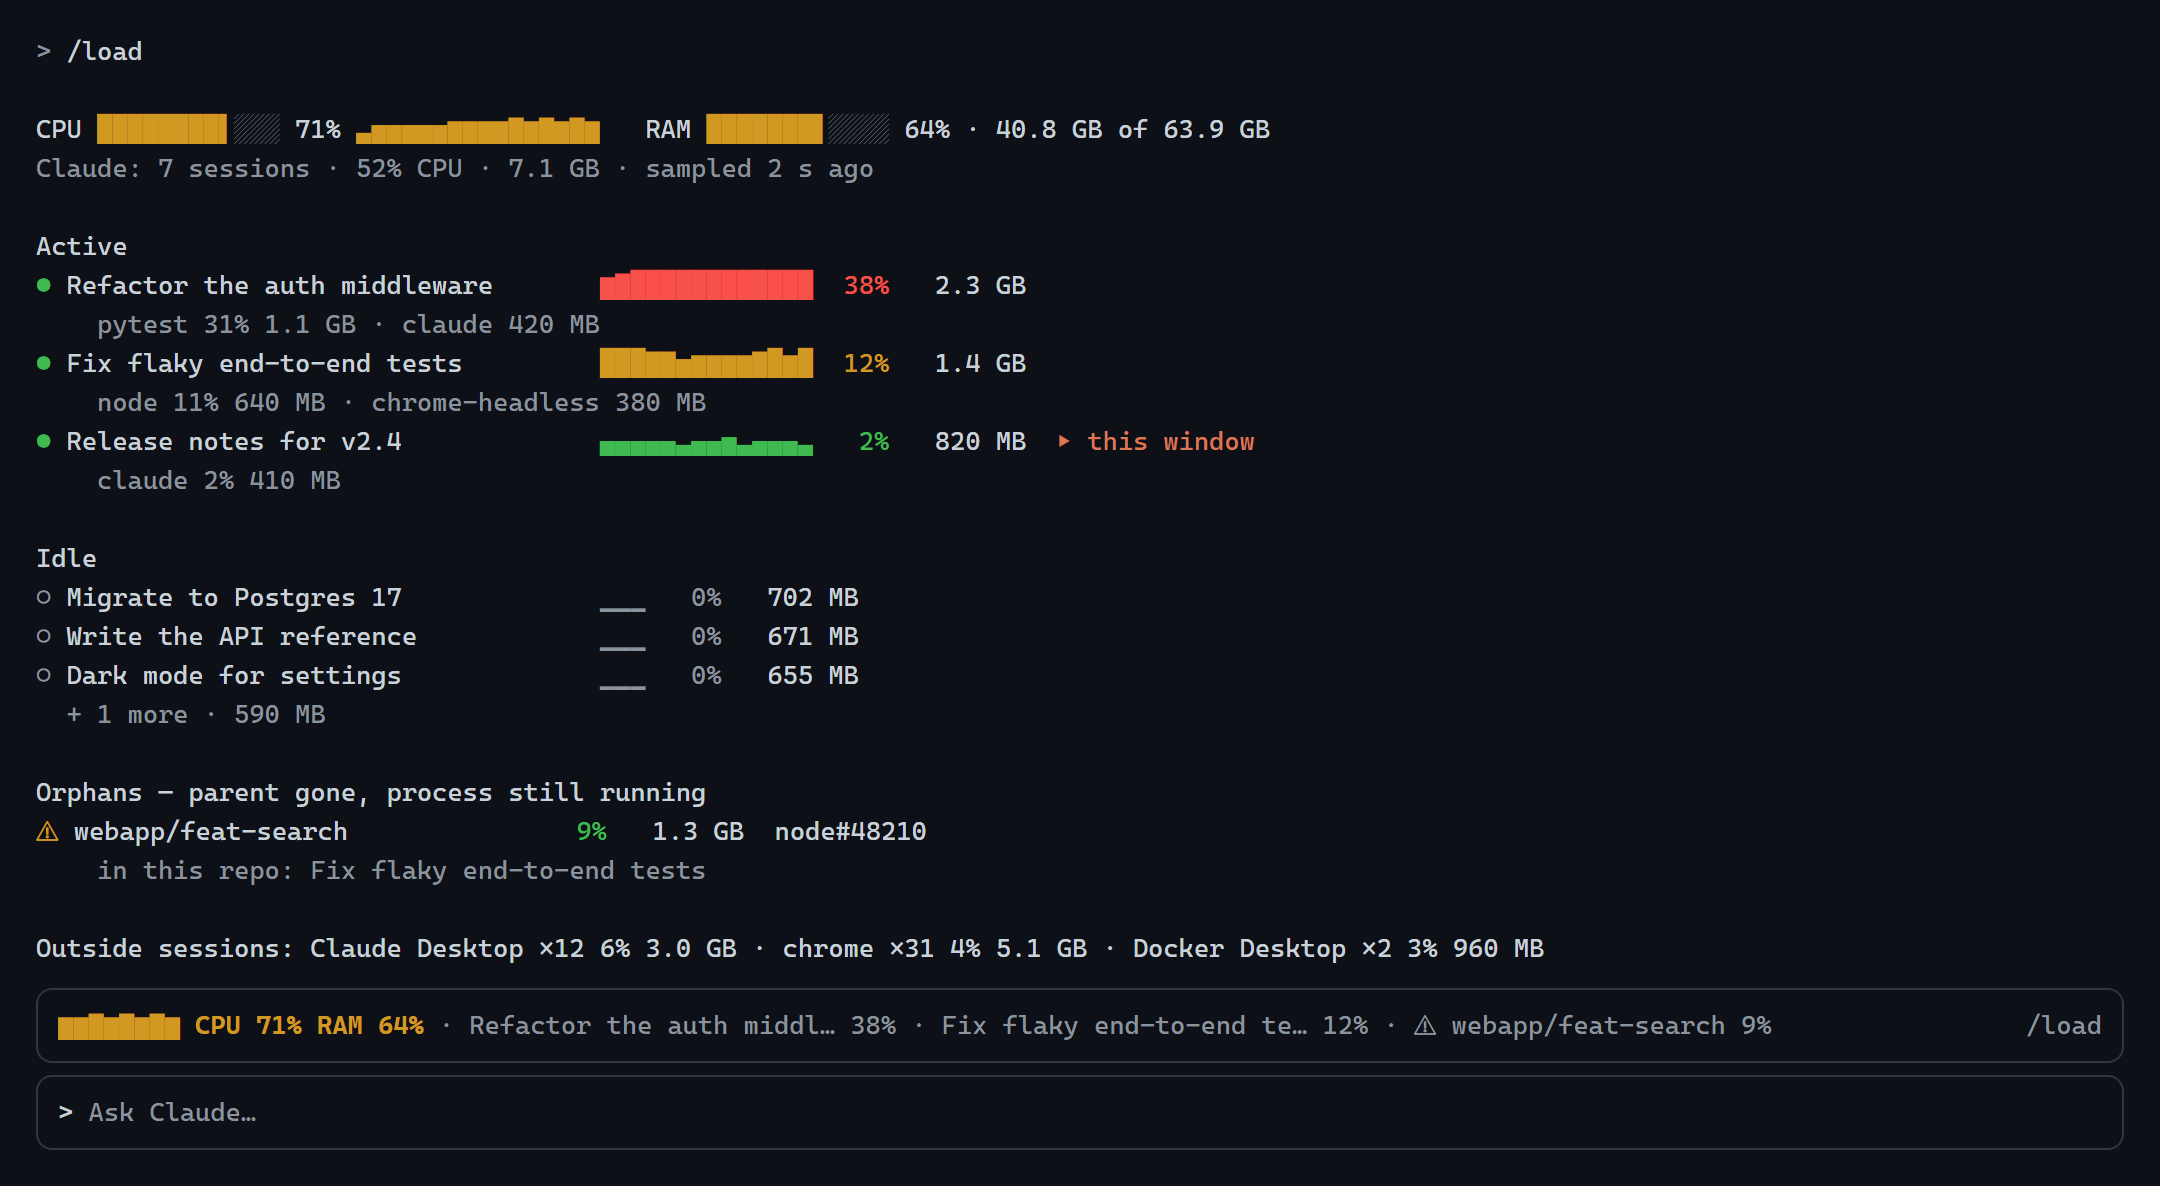
Демо-отчёт /load: активные и простаивающие сессии, процессы без родителя и нагрузка остальных программ. Это не замер автора.
Статья показывает типизированные инструменты, доменные валидаторы и подмену модели в тестах. Для первого опыта полезен TestModel: проверить проводку агента можно без внешнего API.
support.override(model=TestModel()) подменяет модель только на время теста.
ALLOW_MODEL_REQUESTS=False запрещает случайные обращения к платной модели.
Попробовать за вечер
Установить pydantic-ai и описать небольшой инструмент с аннотациями и dataclass зависимостей по примеру статьи.
В pytest подменить модель через TestModel, отключить реальные запросы и проверить, что инструмент получил ожидаемые зависимости.
Метрика: Тест выполняется без сетевого вызова; намеренно сломанная регистрация инструмента или зависимость приводит к провалу.
Границы рецепта. Вспомогательный FakeHttp в статье не реализован. TestModel проверяет вызовы инструментов и зависимости, а качество живой модели нужно оценивать отдельно.
Хранить QA-процесс агента в Git и отделить CI от реальной операции
Павел ЛесюкХабр≈13 минТестирование IT-системИскусственный интеллект
О чём
Автор собирает требования, инварианты и карту покрытия в отдельном QA-репозитории. На примере TON Connect показано, какие доказательства готовит агент и где результат утверждает инженер.
Главное
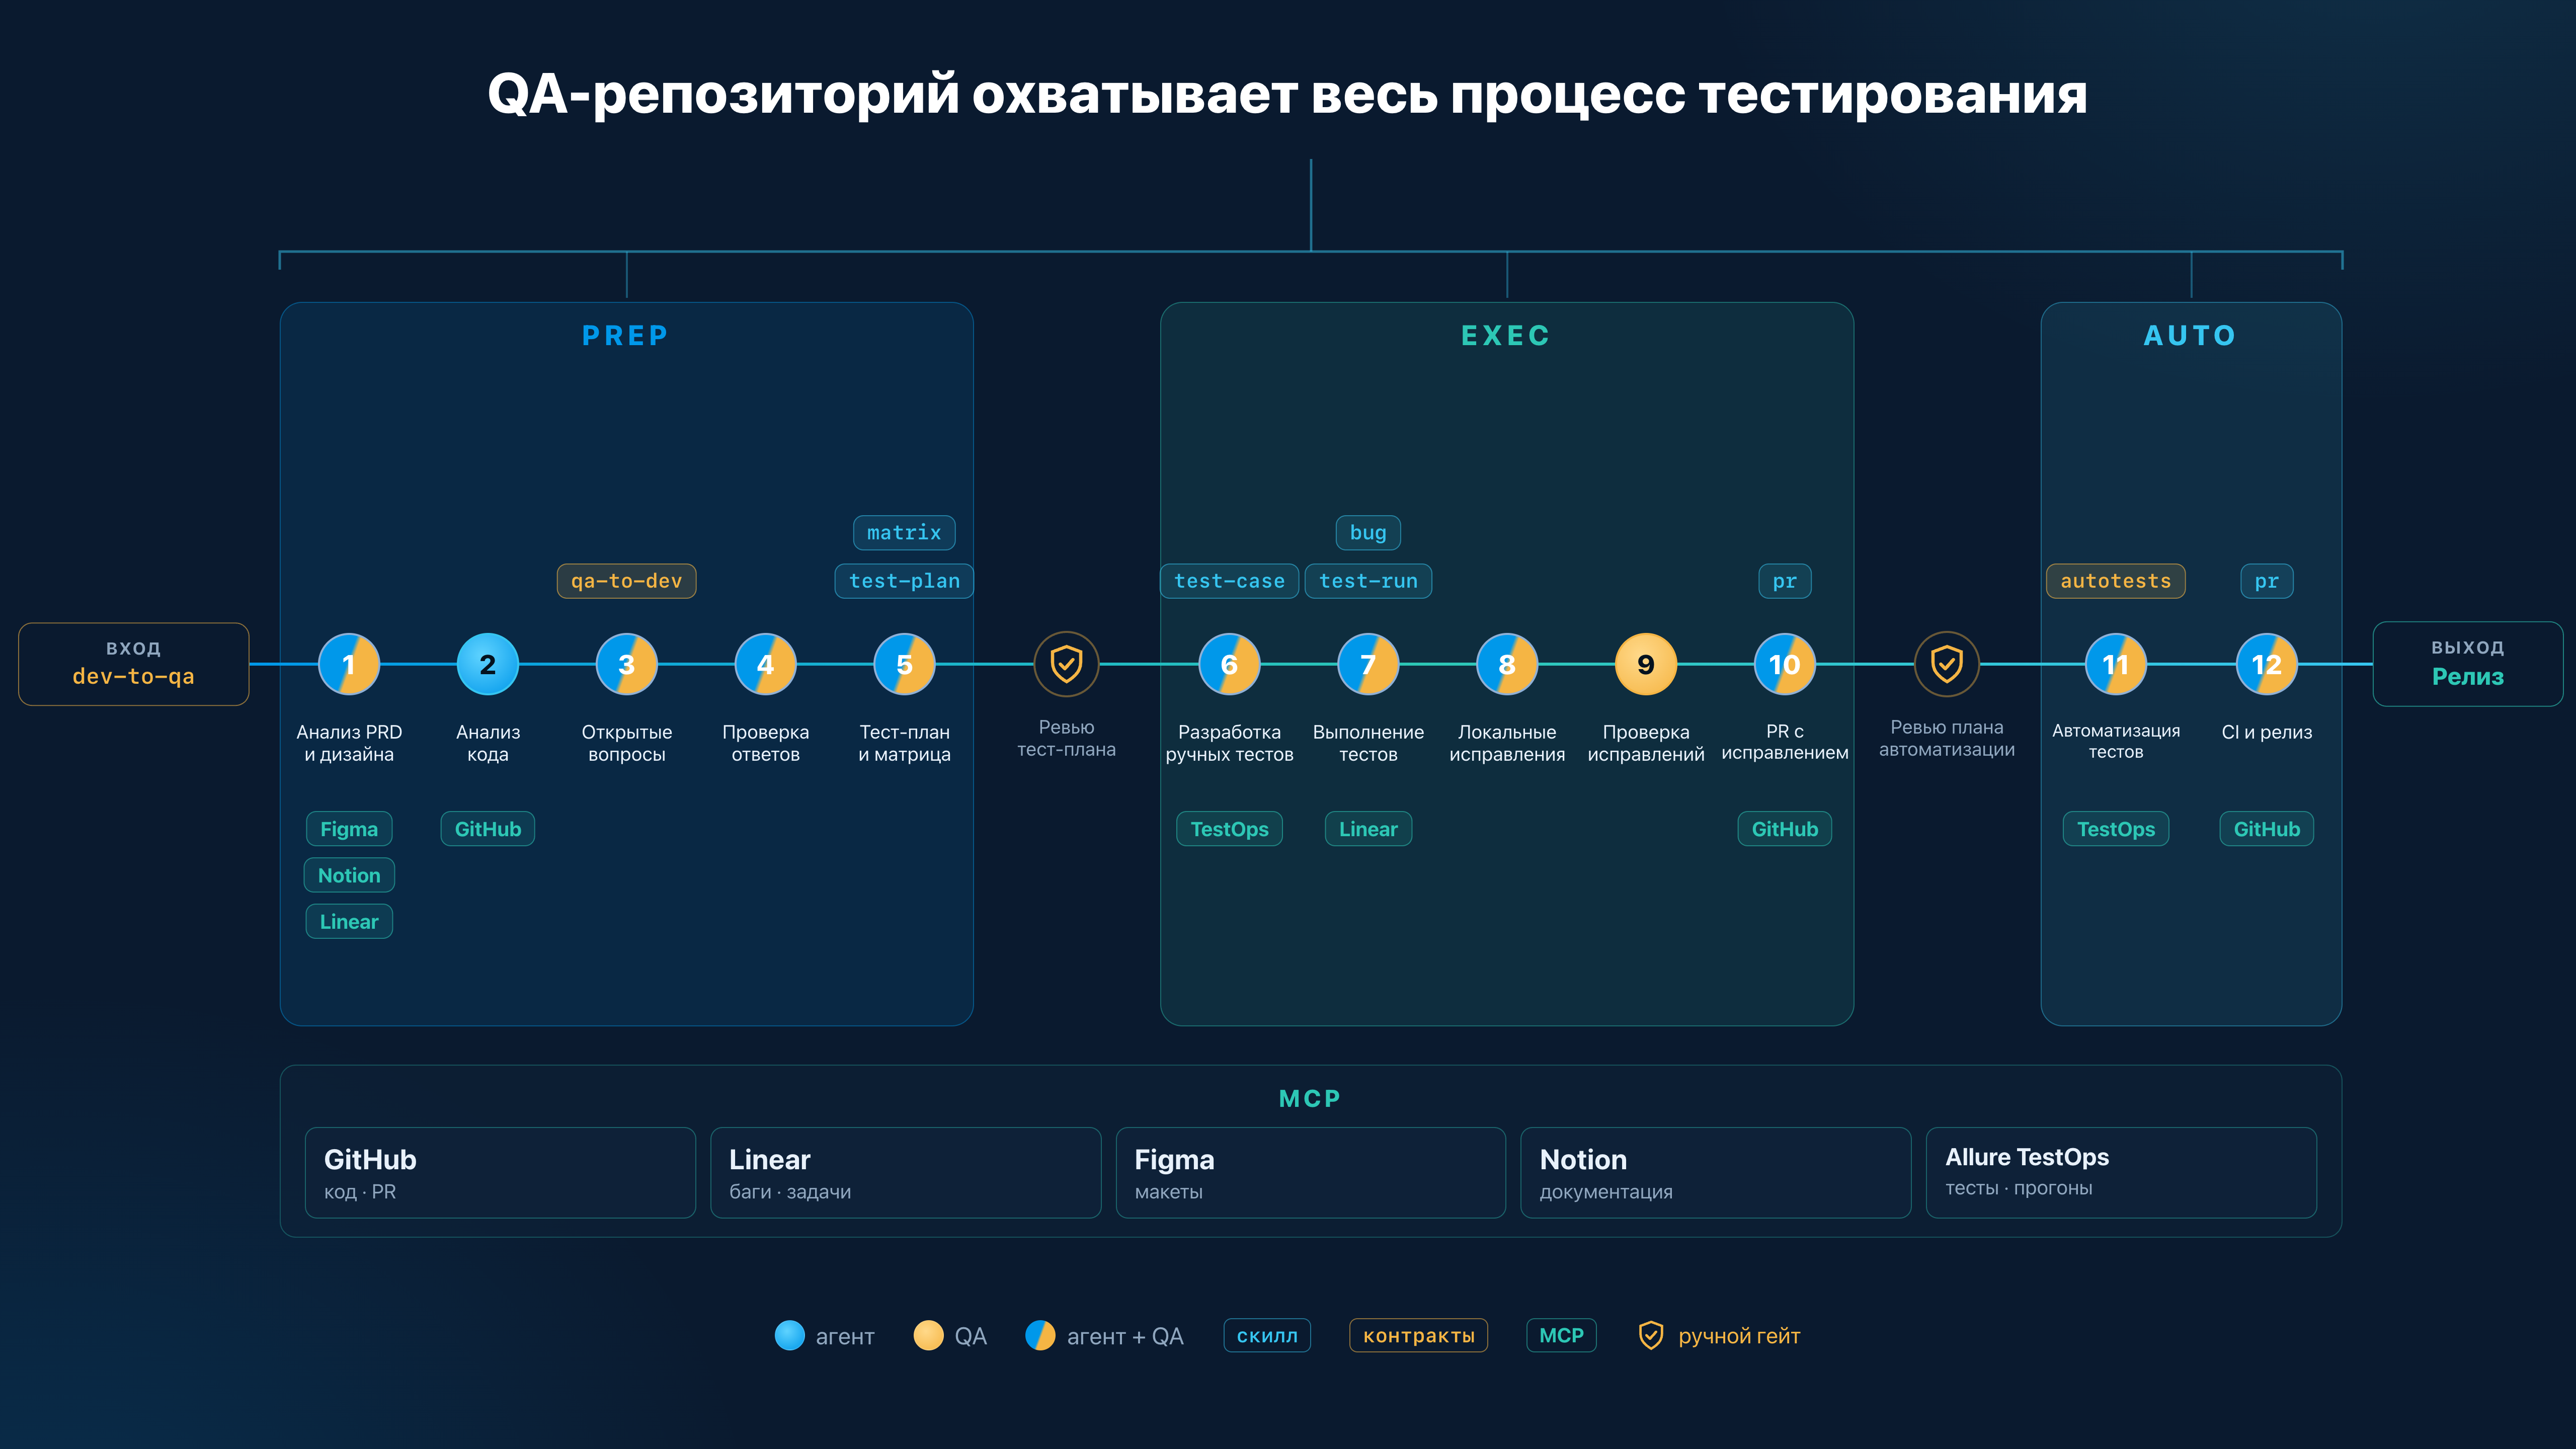
PREP заканчивается утверждённым тест-планом и картой покрытия, EXEC фиксирует проверенные находки.
UI-тест с мок-релеером проверяет сформированный запрос, но не выполнение транзакции в сети.
Реальные отправки исключаются из CI через метку @real-send.
Попробовать за вечер
Взять структуру github.com/lesyuk/process-as-code-agentic-qa и описать инварианты одной интеграционной фичи.
Для одного теста записать границы моков и отделить сценарий реальной записи меткой @real-send от обычного CI.
Метрика: Каждый выбранный сценарий имеет источник ожидания и явную границу: что тест доказывает, а что осталось непроверенным.
Границы рецепта. Часовые оценки автора операционные, без контролируемого эксперимента. Публичный репозиторий обобщает структуру, не содержит всю продуктовую инфраструктуру. Реальные внешние операции требуют отдельного разрешения.
PREP готовит план, EXEC собирает и проверяет находки, AUTO переносит проверки в CI. Между этапами стоят ручные проверки.
Обзор настройки Claude Code: команды проекта, документация, MCP и навыки. Полезен как вводная, но не как законченный рецепт для конкретной инженерной задачи.
Это обзор с рекламными вставками; тарифные и версионные утверждения требуют отдельной проверки. Законченного эксперимента для конкретной задачи нет.
Автор сравнил модели и поисковые инструменты на одном публичном досье компании. Переносимый результат — метод оценки фактов, чтения страниц и сбоев инструмента.
Это эксперимент на одной компании; провайдеры местами менялись, автор признаёт несопоставимость этих клеток. Полного репозитория/команд запуска нет, обвязку придётся реализовать самостоятельно. Не использовать таблицы как универсальный рейтинг моделей.
Практический обзор предлагает сначала отличить сбой поиска от сбоя генерации. Начать можно с контрольного набора, а параметры нарезки проверять на своих документах.
Числа размеров чанков и порог Recall@10 — ориентиры автора, не универсальные нормы. Data Validator закрытый, кода пайплайна нет. Методика проверки повторима на существующей RAG-системе, готового приложения статья не даёт.
Прогнать TestModel с запретом реальных запросов и намеренно сломать один инструмент.
до среды
Сверить код извлечённых RAG-примеров с исходными страницами и разобрать пять расхождений.
до пятницы
Проверить установку своего lock-файла без сети в отдельном окружении.
до воскресенья
Как собран выпуск
Собраны 357 уникальных публикаций. По заголовкам и тизерам оценены 65, полностью прочитаны 20. Восемь основных материалов прошли дополнительную проверку на воспроизводимость; ещё три оставлены на радаре.
Окно: 26 октября – 2 ноября 2026, семь дней.
Источник: постраничный API Хабра; хабы искусственного интеллекта, машинного обучения и обработки языка. Все три хаба покрыли окно. Дополнительно взят осознанный срез top-100 недели.
Пропущенные ленты: нет. Сбор: 2026-11-02T06:59:42.140544Z