Как запустить модель на своей машине, проверить ответы по документации и найти ошибки подключения инструментов.
26 октября – 2 ноября 20268 основных статей3 на радаре
О чём пишут
Авторы недели разбирают задачи, которые возникают при работе с моделями и агентами: переполненный контекст, изменённый код в примерах и непонятный расход памяти. В карточках объясняем, что именно они сделали. Редакционные упражнения обозначены отдельно: их результат предстоит проверить на своих данных и оборудовании.
Восемь разборов с проверкой результата
01
Сохранить план перед новой сессией Pi
Евгений ИгумновХабр≈5 минПрограммированиеИскусственный интеллект
О чём
При работе с локальной моделью история диалога и инструкции занимают часть доступного контекста. Автор подключает LM Studio к агенту Pi, сохраняет план изменений в файл и начинает реализацию в новой сессии. Так агент получает задачу из plan.md без предыдущего обсуждения.
Главное
В ~/.pi/agent/models.json автор задаёт OpenAI-совместимый сервер LM Studio на порту 1234 и contextWindow 65536.
После составления plan.md автор выполняет /new, затем просит агента реализовать сохранённый план.
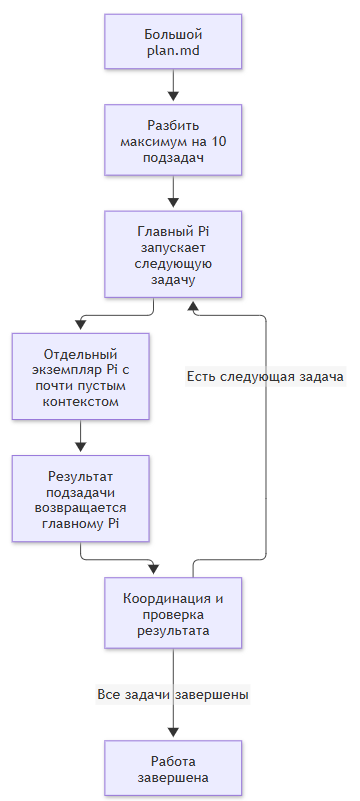
Для более крупных задач skill subtask4llm-pi, набор инструкций для агента, последовательно запускает подзадачи в отдельных экземплярах Pi.
Как проверить у себя
В своём тестовом репозитории можно повторить конфигурацию LM Studio из статьи и выбрать доступную локальную модель.
Дайте Pi небольшую задачу, сохраните план в plan.md и после /new поручите реализацию по этому файлу.
Что проверить: Сравните расход контекста перед правками и долю пройденных тестов с выполнением той же задачи без новой сессии.
Границы рецепта. 125 токенов/с — замер автора на RTX 4070 Ti SUPER, не обещание для другой машины. Часть параметров запуска приведена только на скриншотах; численные сравнения моделей и качества независимо не проверены.
Схема автора: план разбивается на подзадачи. Главный Pi запускает их по очереди в отдельных экземплярах агента с почти пустым контекстом и проверяет результат.
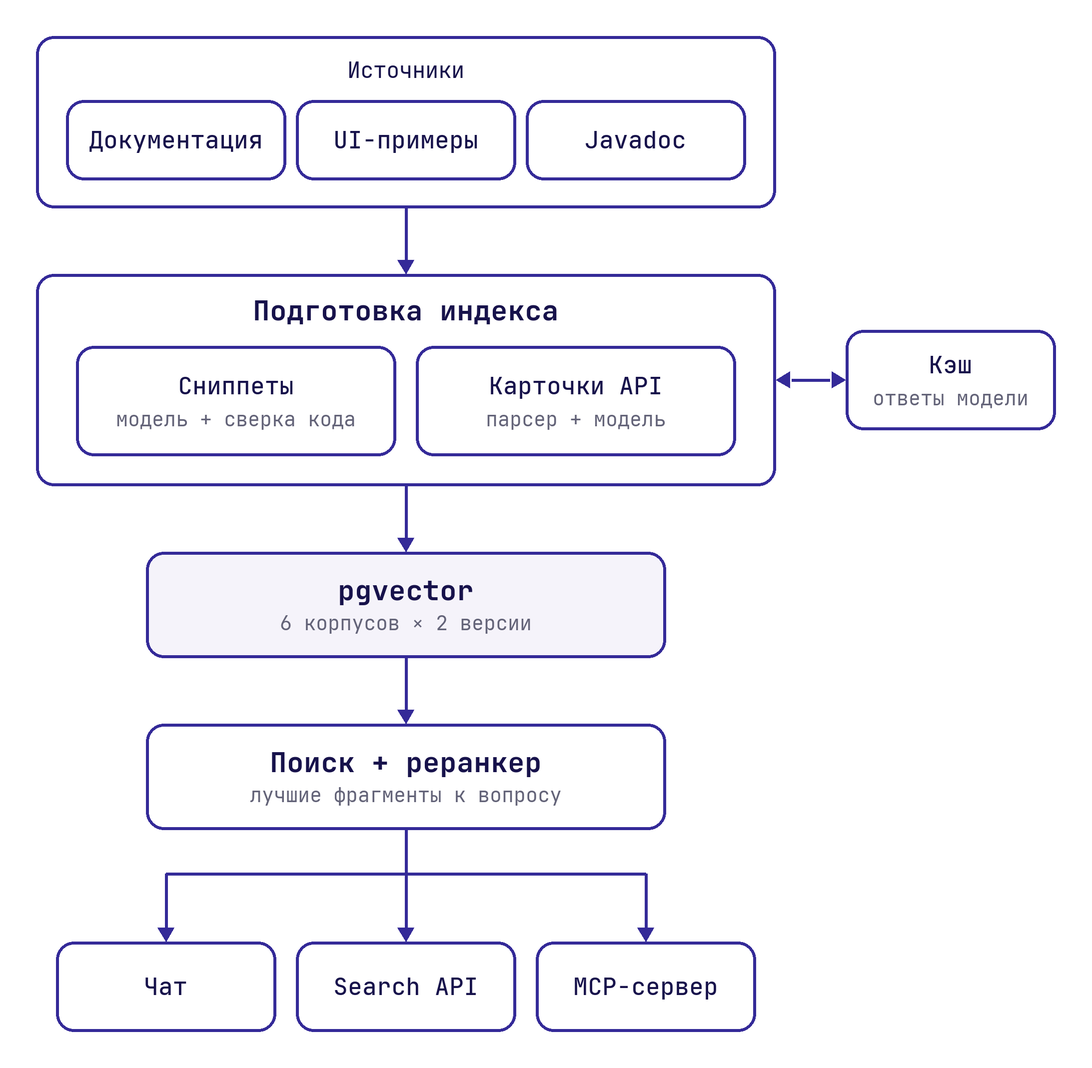
Ассистент Jmix отвечает по документации и примерам API. При подготовке поискового индекса модель может изменить код в извлечённом примере. Команда проверяет каждый такой блок дословным поиском на исходной странице, а ответы ассистента оценивает на наборе вопросов с эталонами. RAG здесь означает поиск материалов перед генерацией ответа.
Главное
Объявления API команда извлекает из Javadoc без модели. Описания для поиска готовит отдельно.
Совпадение блока с исходной страницей подтверждает сохранность кода при извлечении. Работоспособность самого примера требует отдельной проверки.
Новая конфигурация получила 71 зачёт из 74 в каждом из двух прогонов; исходная получила 68 и 70. Авторы разобрали ошибки ответов, эталонов и автоматического оценщика, но не считают эти числа доказательством преимущества.
Как проверить у себя
В своей RAG-системе можно начать с нескольких страниц документации: выделить законченные примеры и проверять наличие каждого блока кода на исходной странице.
Соберите вопросы с эталонами, включая вопрос о несуществующем методе. Сравните две конфигурации поиска и вручную разберите расхождения с оценщиком.
Что проверить: Посчитайте долю примеров, чей код найден в источнике, и ответы с несуществующим API. Повторите прогон, чтобы увидеть разброс.
Границы рецепта. Готового стенда в статье нет: индексатор и вопросы придётся подготовить. Корпуса, поиск и промпт менялись одновременно, поэтому два прогона не позволяют установить причину различий. MCP и Search API авторы количественно не оценивали.
Схема Jmix: документация, примеры интерфейса и Javadoc проходят подготовку для поискового индекса. Найденные фрагменты после повторного ранжирования поступают в чат, Search API и MCP-сервер.
В авторском сервисе поиска новостей с генерацией ответов (RAG) Ollama обслуживает две модели. Диалоговая модель пишет ответ, а модель эмбеддингов переводит текст в векторы для поиска документов. Переключение между ними требует повторной загрузки. Автор разрешает Ollama держать обе модели в памяти, а поиск статей и подсчёт показателей даёт агенту как отдельные инструменты. Сервис собран на PostgreSQL, Ollama и LangGraph.
Главное
Параметр OLLAMA_MAX_LOADED_MODELS=2 разрешает одновременную загрузку двух моделей. Для этого должно хватать памяти.
Инструменты search_articles, get_metrics и search_by_entity разделяют поиск, SQL-подсчёты и выборку по сущности. Агенту не нужно вычислять показатели по тексту найденных статей.
Автор также заменил ChatOllama на ollama.AsyncClient. В задачах Celery он освобождает пул соединений через await engine.dispose().
Как проверить у себя
Если хотите повторить сервис, откройте https://github.com/tzar26/news_scrapper, подготовьте конфигурацию по README и выполните docker compose up -d.
В своей установке Ollama можно проверить OLLAMA_MAX_LOADED_MODELS=2: чередуйте запросы к диалоговой модели и модели эмбеддингов.
Что проверить: Сравните время первого и повторного запроса при переключении моделей и расход памяти. Для get_metrics отдельно сверьте ответ с SQL-подсчётом.
Границы рецепта. Автор не приводит размер контрольной выборки и условия замера Recall@5, показателя полноты поиска среди первых пяти результатов. Рост 0,2→0,53 нельзя переносить на другой корпус. Упоминание PostgreSQL tsvector также не подтверждает реализацию BM25. Запуск зависит от README и доступной памяти.
Алексеев БрониславХабр≈11 минБлог компании BotHubИскусственный интеллект
О чём
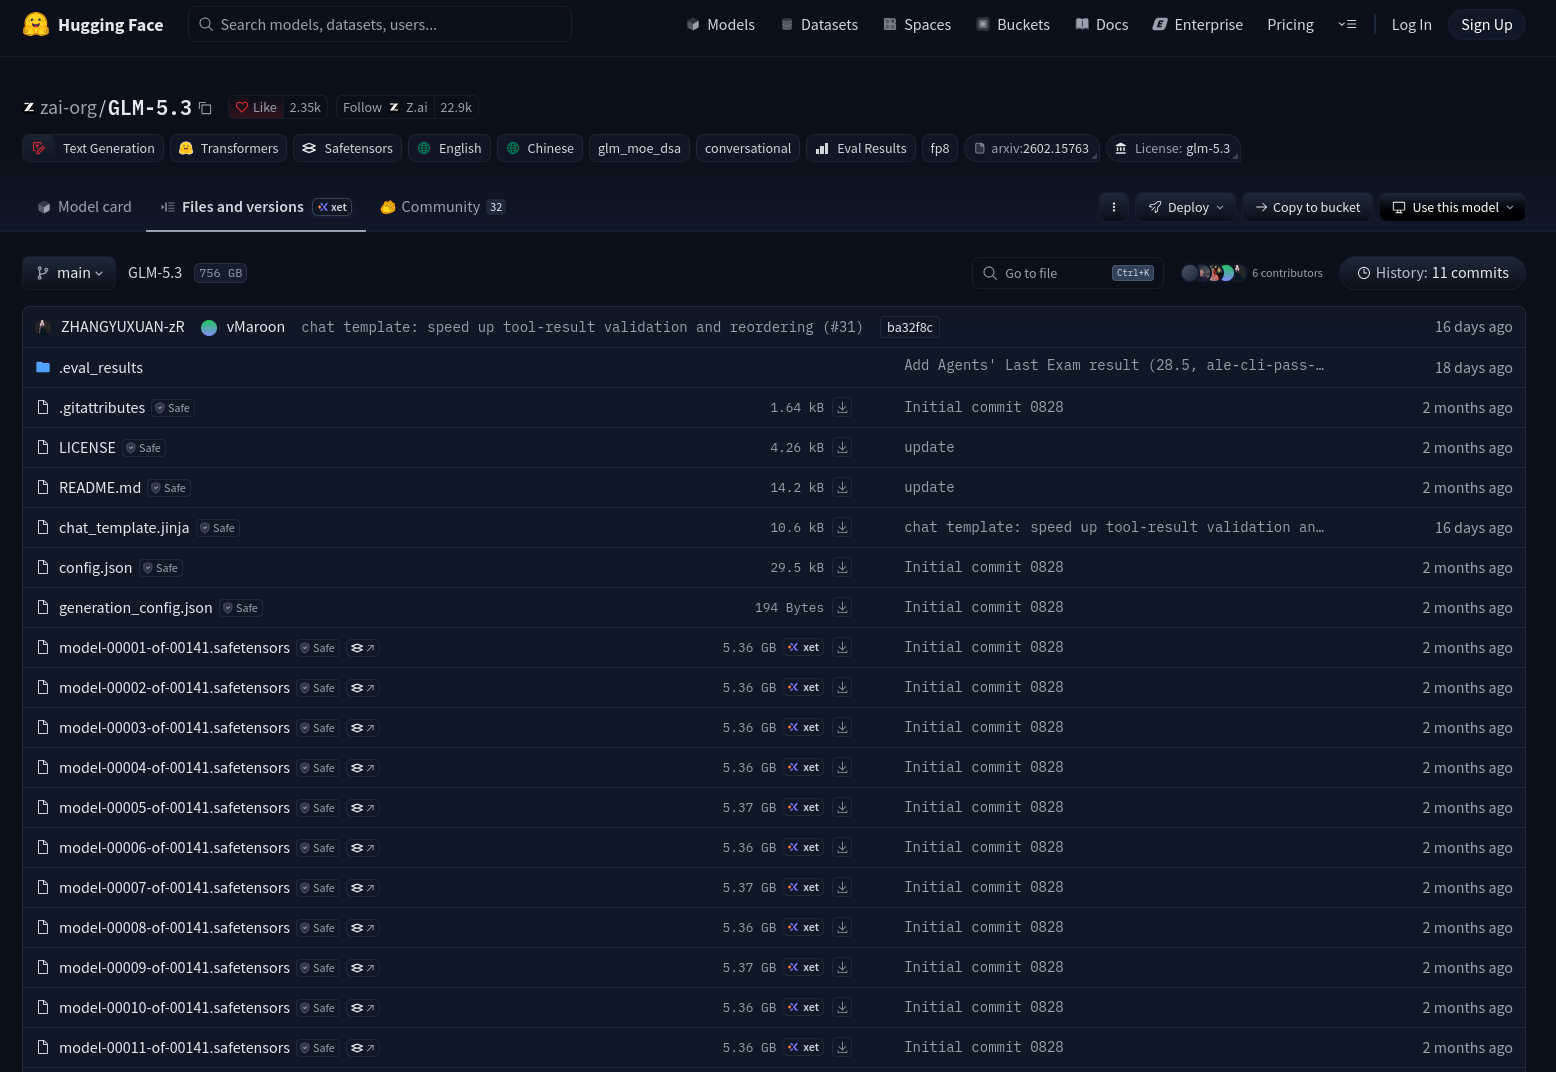
Перед локальным запуском модели нужно выбрать совместимый файл и убедиться, что он помещается в память. Автор показывает, где на Hugging Face проверить назначение, лицензию и размер весов, а затем запустить модель в Ollama. Для первого опыта в статье есть команда для небольшой Llama 3.2 в формате GGUF.
Главное
Перед загрузкой автор предлагает проверить задачу модели, лицензию, объём весов и поддержку архитектуры движком запуска.
Для диалога выбирают instruct- или chat-версию, обученную следовать инструкциям. Base-модель прежде всего продолжает текст.
Ollama принимает адрес hf.co/автор/репозиторий. Вариант квантования, который уменьшает объём весов, можно выбрать тегом.
Как проверить у себя
Откройте bartowski/Llama-3.2-1B-Instruct-GGUF и проверьте лицензию и размер выбранного файла.
Если Ollama уже установлена, выполните команду из статьи: ollama run hf.co/bartowski/Llama-3.2-1B-Instruct-GGUF. Задайте одинаковые вопросы в нескольких сессиях.
Что проверить: Проверьте, что файл загружается без ошибки архитектуры, модель следует инструкциям и её расход памяти подходит вашей машине.
Границы рецепта. Установка Ollama в этом примере предполагается. В статье перепутано соотношение объёмов float16 и float32, поэтому размер файла следует проверять в репозитории. Общие обещания точности квантования не подтверждают качество выбранной модели.
Вкладка Files and versions на Hugging Face показывает файлы весов и их размеры. На авторском скриншоте открыта GLM-5.3; в упражнении карточки используется небольшая Llama.
На машине без сети pip не сможет скачать недостающие пакеты. Автор готовит перенос локального AI-стека на Debian 12: фиксирует версии работающего Python-окружения и заранее скачивает установочные файлы. На целевой машине pip устанавливает их из каталога offline_packages без обращения к PyPI.
Главное
Файл requirements.lock хранит версии из работающего venv, а offline_packages содержит установочные файлы этих зависимостей.
CPU-сборку PyTorch автор скачивает с дополнительного индекса. Суффикс +cpu отличает её от сборки с CUDA.
Файлы моделей, бинарные программы и системные пакеты не входят в набор pip. Их нужно подготовить для переноса отдельно.
Как проверить у себя
В своём работающем окружении можно сохранить вывод pip freeze в requirements.lock и скачать зависимости через pip download с --only-binary=:all: и CPU-индексом PyTorch.
Создайте отдельное окружение и установите lock-файл с --no-index --find-links=./offline_packages. Выполните pip check до удаления этого окружения.
Что проверить: Установка должна завершиться без сети, pip check не должен найти конфликтов, а torch должен сообщить версию с +cpu.
Границы рецепта. Способ рассчитан на одинаковые ОС, архитектуру и версию Python. Пакеты apt переносят отдельно. В листингах статьи есть лишние обратные слеши, а тестовое окружение удаляется до pip check. Перед запуском нужно исправить запись команд и порядок проверки.
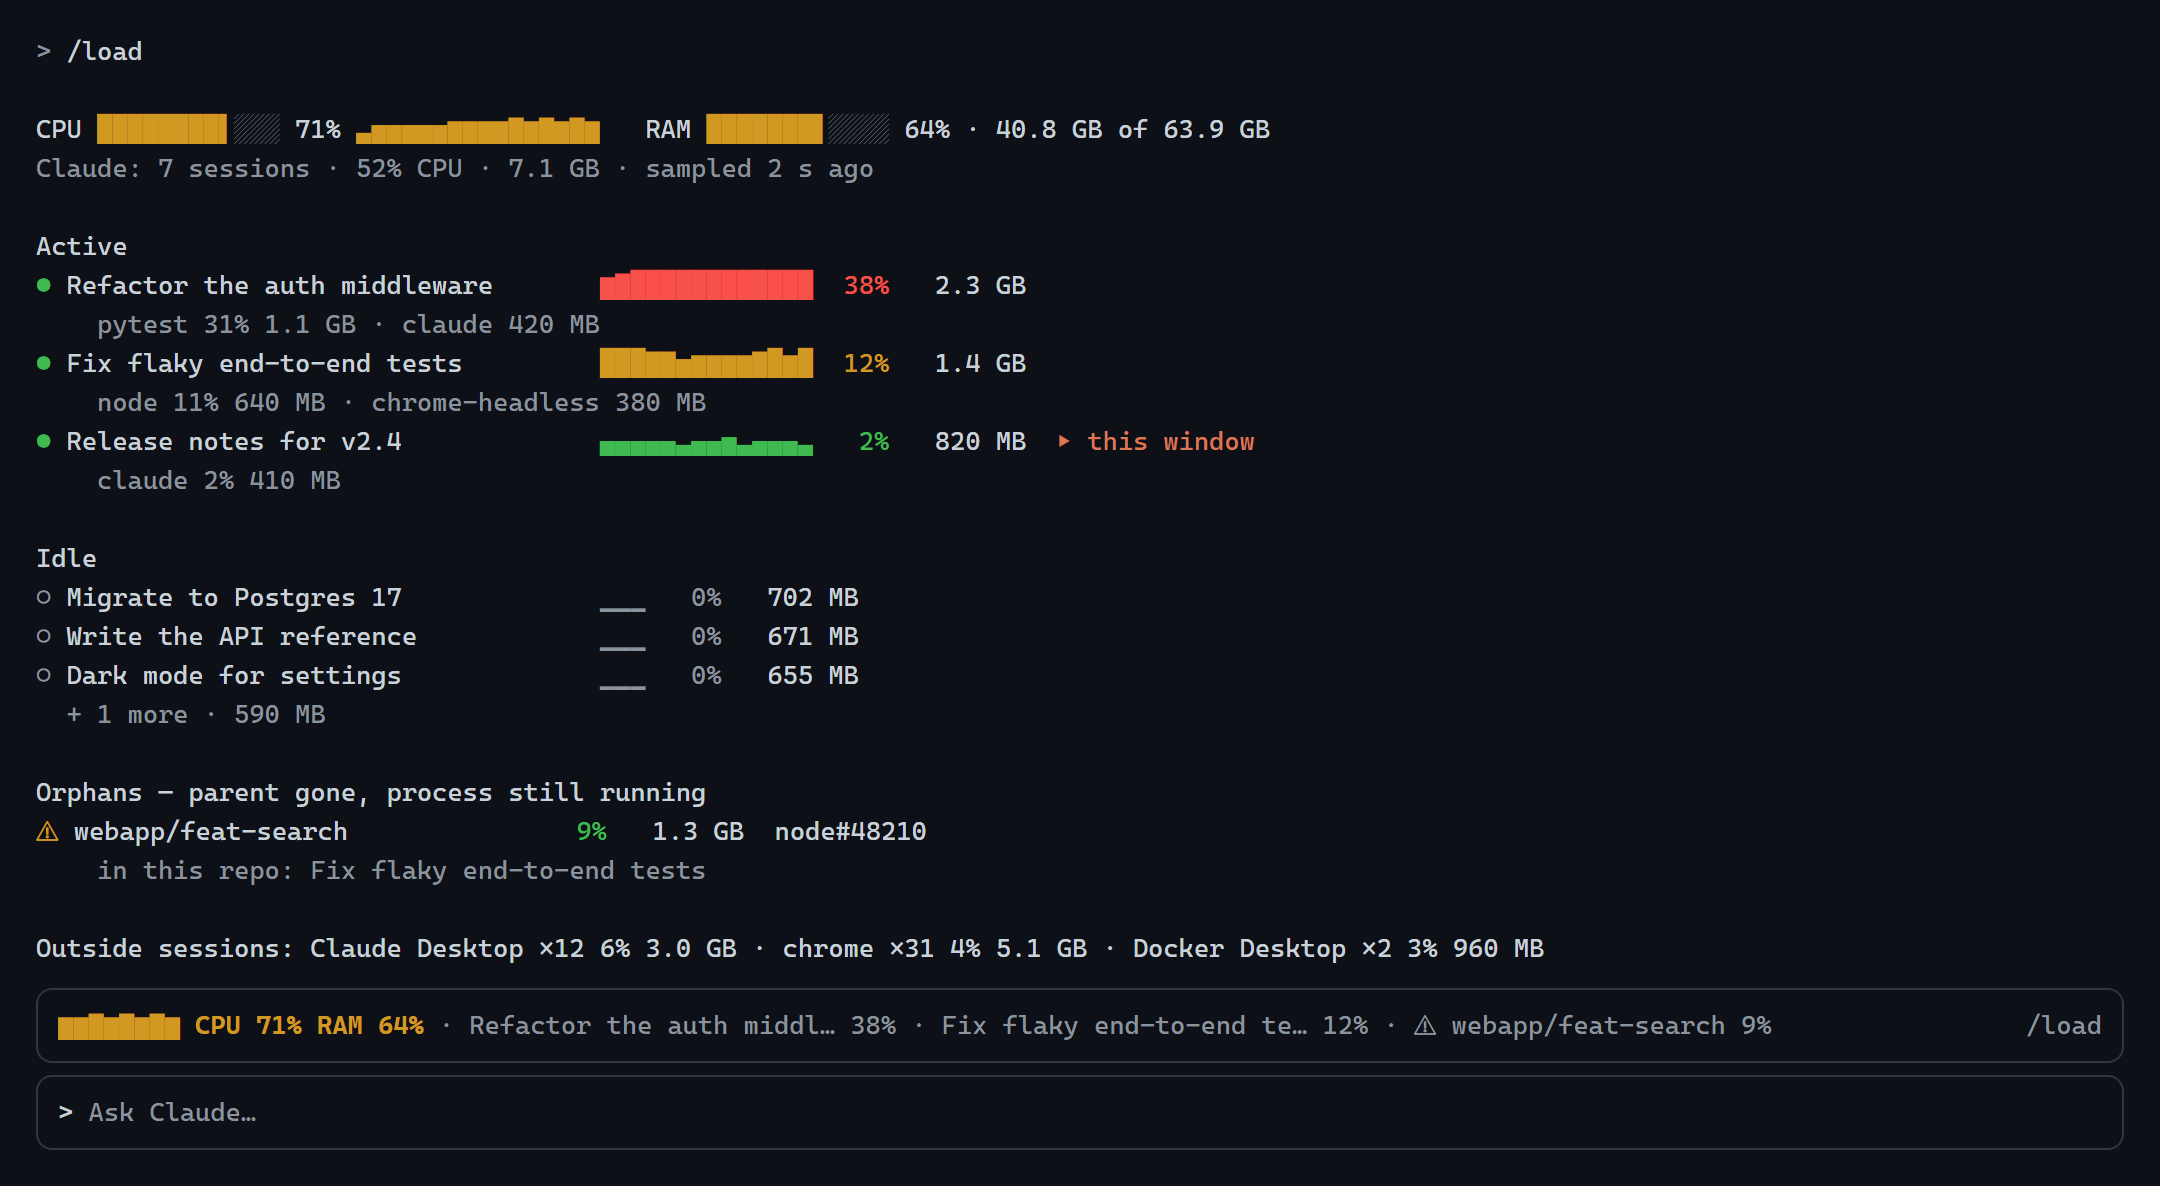
Когда несколько агентов Claude Code работают параллельно, по списку процессов трудно понять, какая задача расходует память. Автор разработал дополнение claude-load, которое связывает процессы с сессиями и отдельно показывает процессы, оставшиеся без родителя. Пока это реализация с демонстрационными данными: на настоящих macOS и Linux автор её не запускал.
Главное
Дополнение читает ~/.claude/sessions/<pid>.json. Для каждого процесса оно поднимается по цепочке родителей, используя PPID, идентификатор родительского процесса, пока не найдёт сессию Claude Code.
Один сборщик записывает snapshot.json. Сессии читают общий снимок раз в пять секунд.
Перед завершением процесса реализация проверяет свежесть снимка и соответствие имени идентификатору PID.
Как проверить у себя
Для проверки на своей машине можно установить дополнение по командам статьи: при Claude Code 2.1.287+ добавить маркетплейс Gerrux/claude-load и установить claude-load@claude-load.
Выполните /reload-plugins и /load. Сначала сопоставьте показанные процессы со своими запущенными задачами; результаты дополнения требуют проверки.
Что проверить: Проверьте, видны ли CPU и RAM активных сессий и верно ли отнесён к сессии знакомый дочерний процесс.
Границы рецепта. Автор прямо пишет: «На настоящем Mac или Linux мод пока не запускался». Скриншоты построены на демо-данных, а реестр сессий не документирован. Пригодность дополнения для своей версии Claude Code нужно установить экспериментом.
Демонстрационный отчёт /load показывает нагрузку активных сессий, простаивающие сессии и процессы без родителя. Автор создал скриншот на демо-данных.
Ошибка агента Pydantic AI может возникнуть в подключении инструмента или передаче зависимостей ещё до ответа модели. Автор показывает, как подменить модель через TestModel и проверить эту часть программы в тестах. Такие тесты помогают найти ошибки интеграции без обращения к внешнему API.
Главное
Параметр output_type проверяет формат результата. Функция output_validator добавляет ограничения предметной области.
Вызов support.override(model=TestModel()) подменяет модель на время теста.
Параметр ALLOW_MODEL_REQUESTS=False запрещает случайные реальные запросы к модели.
Как проверить у себя
В своём тестовом проекте можно установить pydantic-ai и описать инструмент с аннотациями типов по образцу статьи. Его зависимости оформите как dataclass, класс данных Python.
В pytest используйте TestModel, запретите реальные запросы и проверьте передачу зависимостей в инструмент. Затем намеренно нарушьте регистрацию инструмента или передачу зависимости.
Что проверить: Тест должен выполняться без сетевого вызова и обнаруживать внесённую ошибку подключения.
Границы рецепта. Вспомогательный FakeHttp в статье не реализован, его придётся подготовить. TestModel проверяет вызовы инструментов и передачу зависимостей. Качество ответов используемой в работе модели оценивают отдельно.
Павел ЛесюкХабр≈13 минТестирование IT-системИскусственный интеллект
О чём
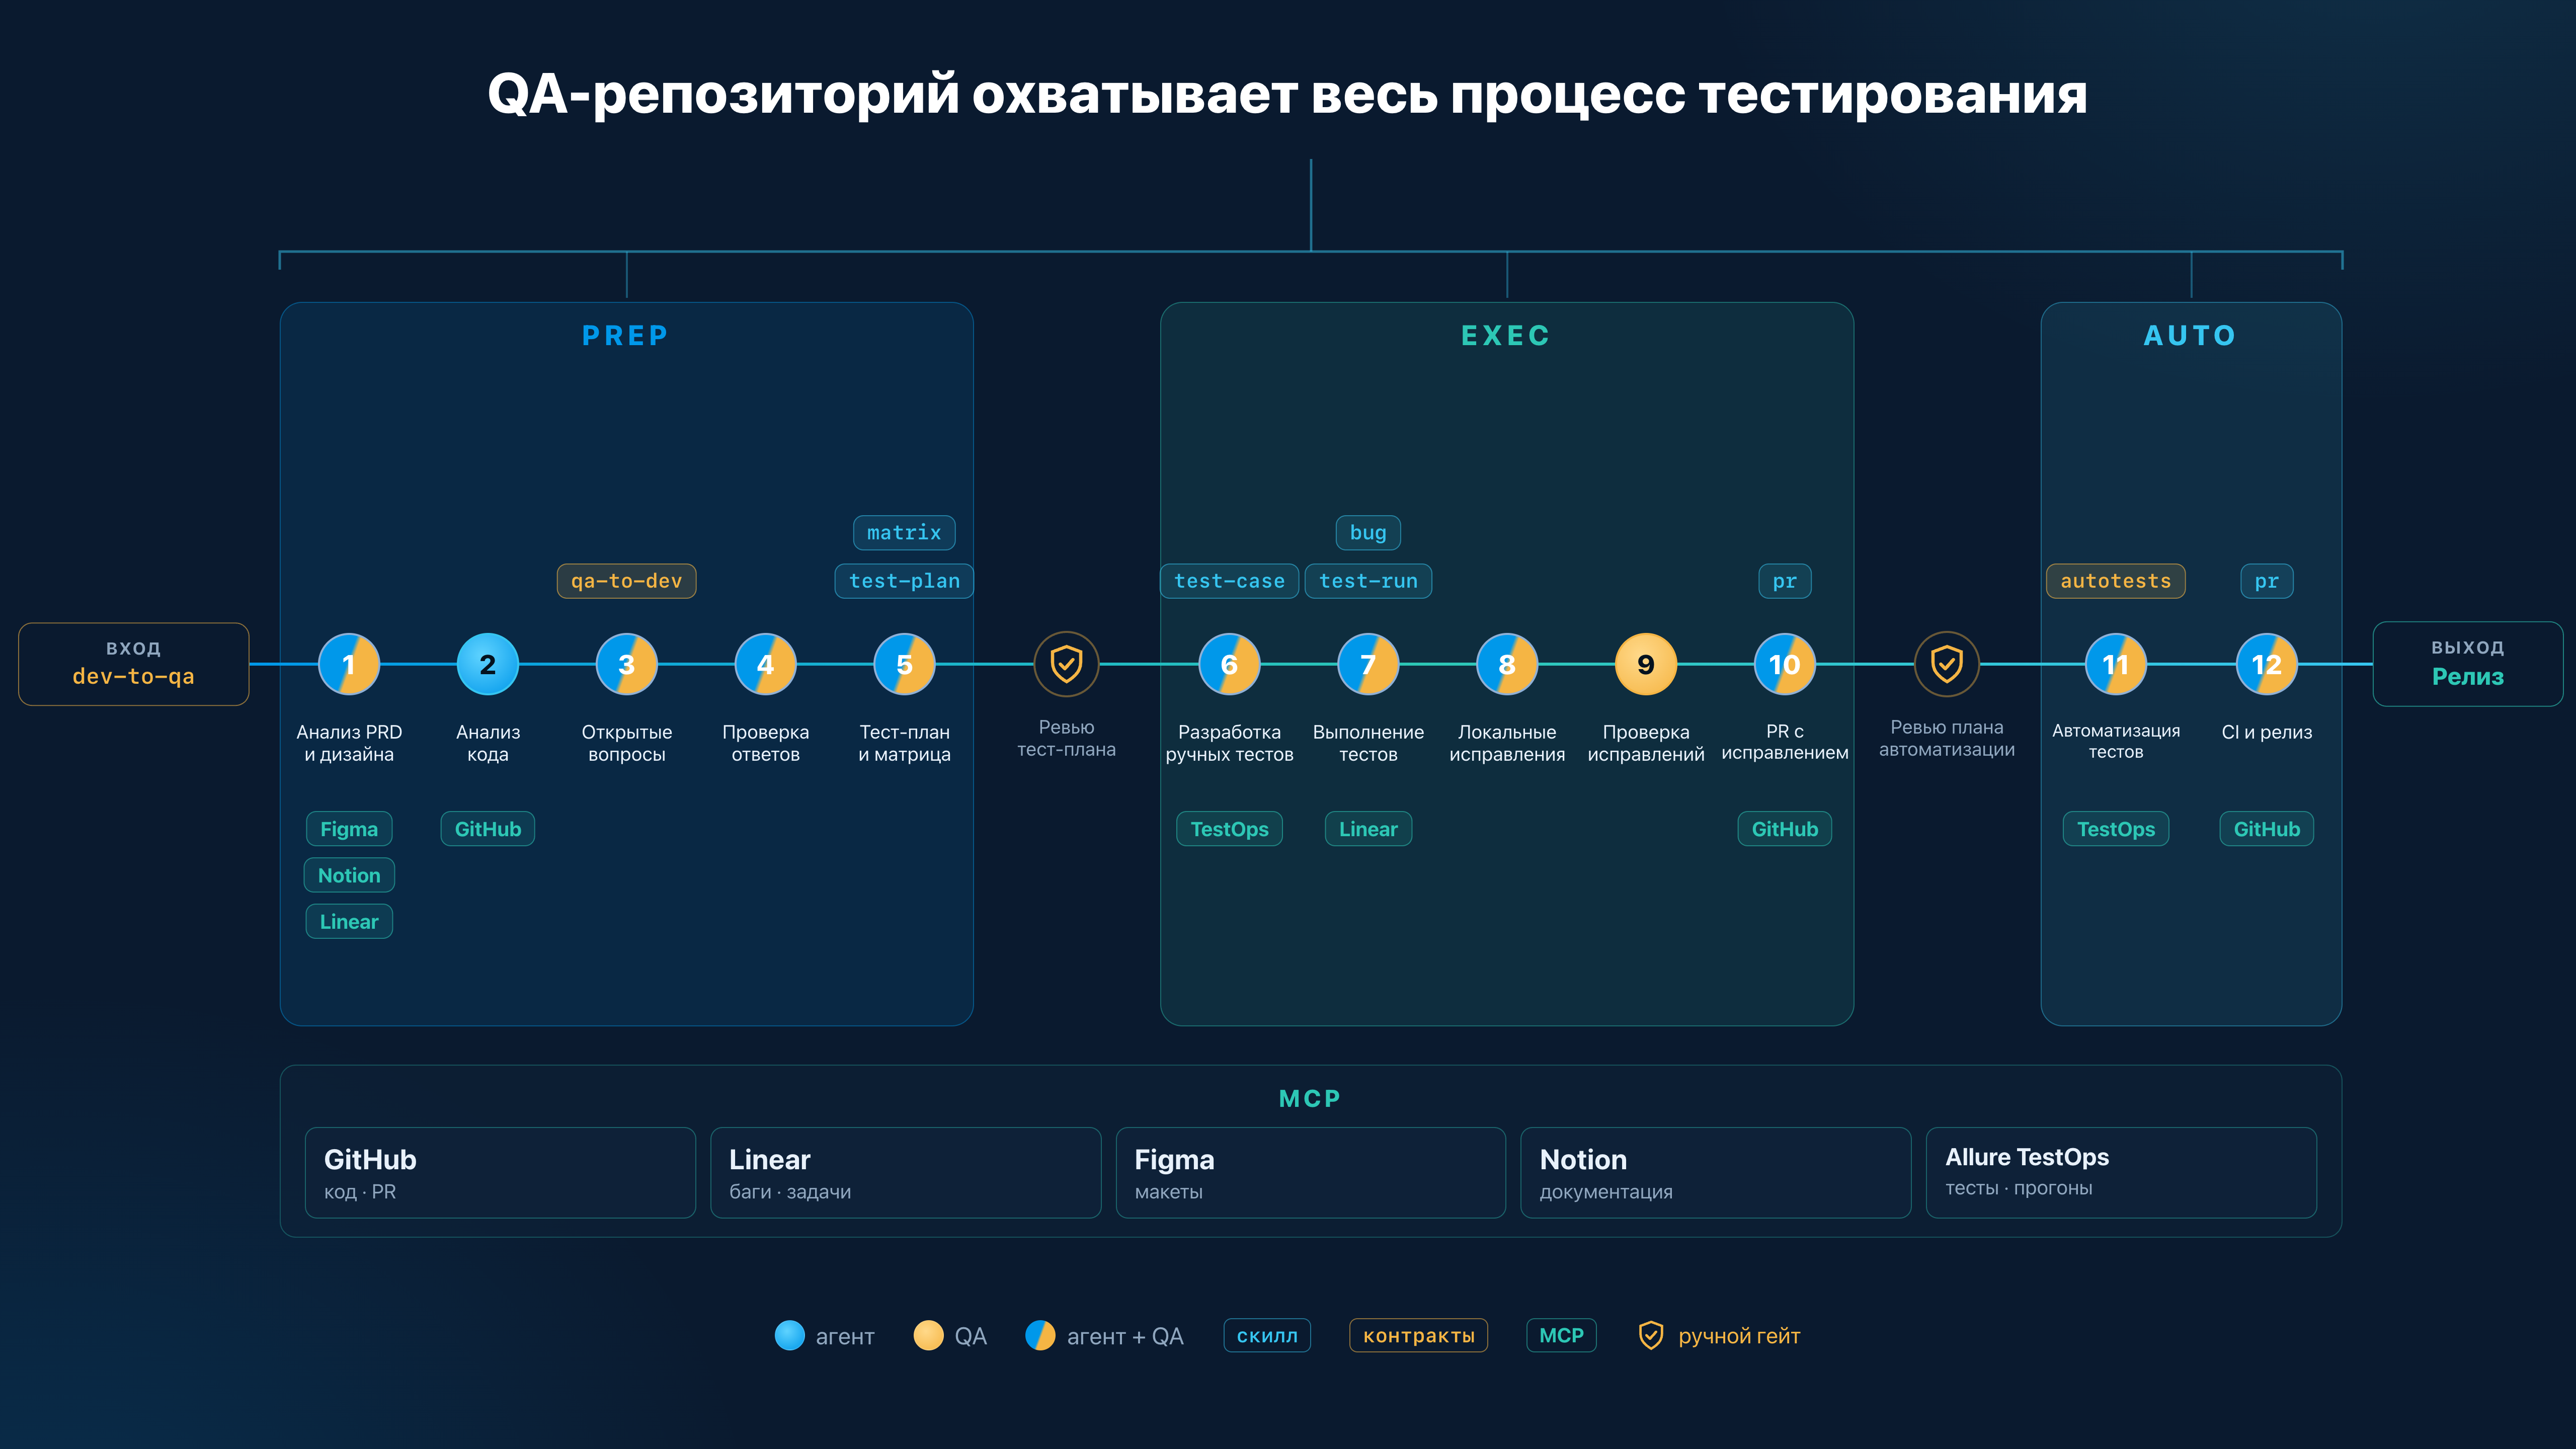
При проверке интеграции тест с подменённым внешним сервисом может пройти, хотя реальная операция остаётся непроверенной. На примере подключения приложения к кошельку через TON Connect автор хранит требования, неизменяемые условия и карту покрытия в отдельном QA-репозитории. Агент готовит материалы проверки, а инженер утверждает результат на границах этапов.
Главное
Этап PREP завершается утверждённым тест-планом и картой покрытия. На этапе EXEC агент фиксирует проверенные находки.
UI-тест с мок-релеером, подменой сервиса отправки, проверяет сформированный запрос. Выполнение транзакции в сети он не подтверждает.
Сценарии с реальной отправкой помечены @real-send и исключены из CI, автоматических проверок при изменении кода.
Как проверить у себя
В своём проекте можно взять структуру github.com/lesyuk/process-as-code-agentic-qa и описать обязательные условия одной интеграционной функции.
Укажите у одного теста, какие сервисы подменены и что подтверждает результат. Сценарий реальной записи отделите меткой @real-send от обычного CI по образцу статьи.
Что проверить: У каждого выбранного сценария должны быть источник ожидаемого результата и перечень того, что осталось за пределами проверки.
Границы рецепта. Публичный репозиторий содержит обобщённую структуру, а не всю инфраструктуру продукта. Оценки времени у автора получены в работе без контролируемого сравнения. Реальные внешние операции требуют отдельного разрешения.
Схема QA-процесса автора: PREP готовит план, EXEC фиксирует результаты проверки, AUTO добавляет автоматические тесты. Переходы между этапами требуют решения инженера.
Если команды сборки и правила проекта приходится повторять агенту в каждой сессии, автор предлагает начать с /init. Команда создаёт CLAUDE.md, который нужно проверить вручную. Это вводный обзор настройки Claude Code; в своём репозитории можно сверить сгенерированные команды с действительными командами сборки и тестов.
В обзоре есть рекламные вставки и тарифные сведения, которые здесь не проверялись. Законченного эксперимента для одной инженерной задачи статья не показывает.
Один удачный ответ поискового агента может скрыть разброс между запусками. Автор вручную собрал эталон по одной компании и сравнил повторные прогоны по семи пунктам. Для проверки своего поиска можно повторить эту методику: заранее зафиксировать факты и проверить, открывал ли агент найденные страницы.
Опыт ограничен одной компанией. В части сравнений менялись провайдеры, поэтому таблицы нельзя использовать как общий рейтинг моделей. Готовых команд запуска нет; программу проверки придётся собрать.
Если RAG даёт неверный ответ, автор предлагает сначала проверить найденные фрагменты. Когда нужного факта среди них нет, проверяют поиск; когда он есть, разбирают генерацию ответа. В своей системе можно сохранить фрагменты и ответы на один набор контрольных вопросов, затем повторить проверку после изменения нарезки документов.
Размеры фрагментов и порог Recall@10, показателя полноты поиска среди первых десяти результатов, приведены как ориентиры автора. Data Validator закрыт, кода обработки документов нет; для применения нужна своя RAG-система.
В своём тесте Pydantic AI подменить модель через TestModel и проверить, что ошибка подключения инструмента обнаруживается без запроса к API.
до среды
Проверить, сохранился ли код при подготовке примеров для RAG: найти извлечённые блоки на исходных страницах и разобрать пять расхождений.
до пятницы
Установить зависимости из своего requirements.lock без сети в отдельное Python-окружение и выполнить pip check.
до воскресенья
Как собран выпуск
Собраны 357 уникальных публикаций. По заголовкам и тизерам оценены 65, полностью прочитаны 20. Для восьми основных материалов проверены описанный способ применения и его ограничения; ещё три оставлены на радаре.
Окно: 26 октября – 2 ноября 2026, семь дней.
Источник: постраничный API Хабра; хабы искусственного интеллекта, машинного обучения и обработки языка. Все три хаба покрыли окно. Дополнительно просмотрены 100 верхних публикаций недельного рейтинга.
Пропущенные ленты: нет. Сбор: 2026-11-02T06:59:42.140544Z